

Insurance fraud is no longer limited to fraudulent claims. Increasingly, insurers face fraud risks during underwriting itself. Fraudsters may misrepresent personal information, conceal risk factors, manipulate premium-related data, or create synthetic identities to obtain policies under favorable terms.
The challenge is that underwriting fraud signals are often scattered across policy administration systems, CRM platforms, external data providers, payment systems, and historical underwriting repositories. As a result, underwriters frequently lack a unified view of applicant risk.
Delta Lake provides a powerful foundation for consolidating these disparate datasets into a centralized fraud feature store that enables advanced fraud detection analytics, supports ML initiatives, and improves underwriting decision quality.
In this article, we explore how insurers can use Delta Lake to combine fraud-related datasets, generate fraud indicators, and empower underwriters with actionable insights.
Why Underwriting Fraud Detection Matters?
Traditional underwriting systems primarily focus on risk assessment and premium calculation. However, sophisticated fraud schemes often exploit data gaps between systems. Some, common underwriting fraud categories include:
Application Fraud
Applicants intentionally provide inaccurate information during policy application. For instance,
- Underreporting property values
- Hiding previous claims history
- Providing false vehicle usage information
Premium Fraud
Applicants manipulate information to reduce premium costs. For instance,
- Incorrect driver information
- False geographic details
- Undisclosed high-risk assets
Identity Fraud
Fraudsters use stolen or synthetic identities to obtain insurance coverage. For example,
- Stolen personal information
- Fabricated identities
- Duplicate applications across channels
The Challenge of Fragmented Fraud Signals
A typical insurer stores fraud-related information in multiple sources:
| Data Source | Fraud Signals |
| Policy System | Application history |
| Claims System | Prior claim patterns |
| CRM Platform | Customer interactions |
| Payment Systems | Premium payment anomalies |
| External Databases | Identity verification results |
Individual systems rarely provide enough information to identify fraud. The real value emerges when these datasets are combined. For example,
- Applicant submitted 3 applications in 30 days.
- Address appears in previous fraud investigations.
- Premium payments originate from multiple unrelated accounts.
Each signal alone may not indicate fraud. But, when combined together, they may reveal a high-risk application.
Building a Fraud Feature Store with Delta Lake
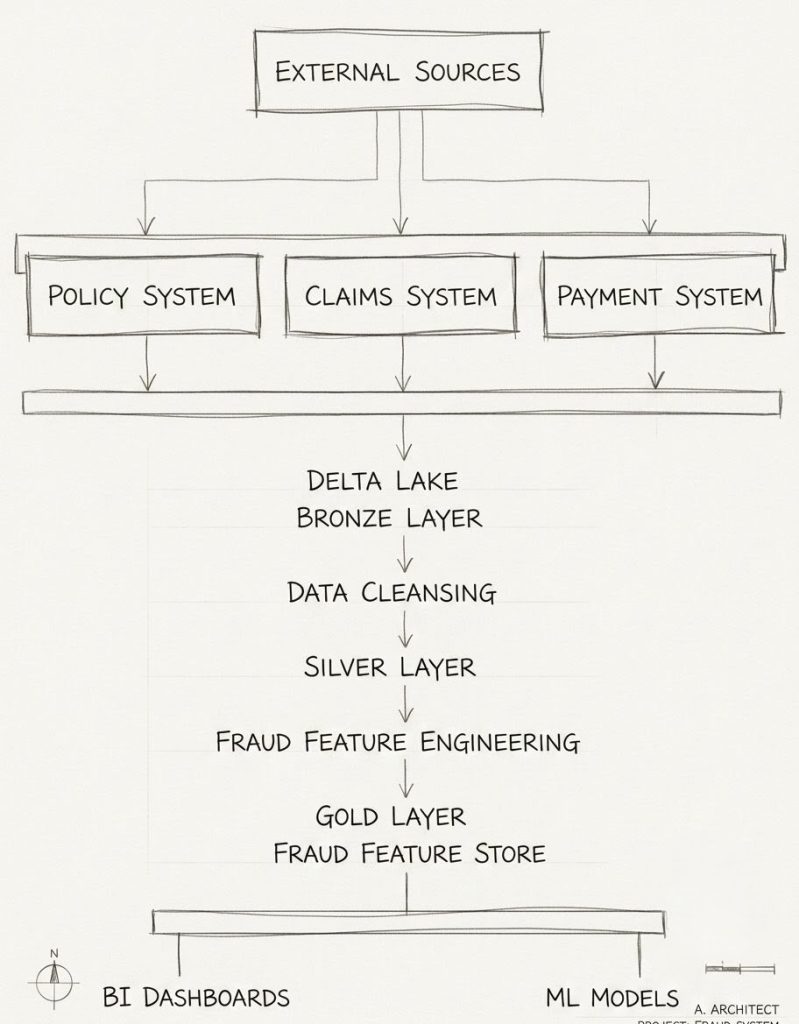
The lakehouse architecture ensures:
- Scalable data ingestion
- Historical traceability
- Data quality controls
- Real-time analytics support
- ML readiness
Sample Dataset
Suppose underwriting systems collect the following information.
applicants = [
    ("A1001","John Smith","Toronto",2,1,False),
    ("A1002","Sarah Jones","Toronto",5,0,False),
    ("A1003","David Brown","Mississauga",1,4,True),
    ("A1004","Jennifer Lee","Toronto",4,3,True)
]
Columns:
- Applicant ID
- Name
- City
- Previous Applications
- Previous Claims
- Identity Verification Failed
Delta Table
from pyspark.sql import SparkSession

spark = SparkSession.builder.getOrCreate()

df = spark.createDataFrame(
    applicants,
    [
        "applicant_id",
        "name",
        "city",
        "previous_applications",
        "previous_claims",
        "identity_verification_failed"
    ]
)

df.write.format("delta").mode("overwrite").save("/delta/fraud_applicants")
Output
| applicant_id | name | city | previous_applications | previous_claims | identity_verification_failed |
| A1001 | John Smith | Toronto | 2 | 1 | False |
| A1002 | Sarah Jones | Toronto | 5 | 0 | False |
| A1003 | David Brown | Mississauga | 1 | 4 | True |
| A1004 | Jennifer Lee | Toronto | 4 | 3 | True |
Engineering Fraud Features
The goal is to create a reusable fraud feature store.
Feature 1: Frequent Application Activity
SELECT
applicant_id,
CASE
WHEN previous_applications >= 4 THEN 1
ELSE 0
END AS application_fraud_flag
FROM fraud_applicants| applicant_id | application_fraud_flag |
| A1001 | 0 |
| A1002 | 1 |
| A1003 | 0 |
| A1004 | 1 |
Feature 2: Prior Claims Activity
Applicants with unusually high claim counts may require additional review.
SELECT
applicant_id,
CASE
WHEN previous_claims >= 3 THEN 1
ELSE 0
END AS claims_risk_flag
FROM fraud_applicants| applicant_id | claims_risk_flag |
| A1001 | 0 |
| A1002 | 0 |
| A1003 | 1 |
| A1004 | 1 |
Feature 3: Identity Verification Failures
SELECT
applicant_id,
CASE
WHEN identity_verification_failed = TRUE
THEN 1
ELSE 0
END AS identity_fraud_flag
FROM fraud_applicants| applicant_id | identity_fraud_flag |
| A1001 | 0 |
| A1002 | 0 |
| A1003 | 1 |
| A1004 | 1 |
Creating the Fraud Feature Store
A feature store centralizes all fraud indicators for downstream use.
SELECT
applicant_id,
CASE WHEN previous_applications >=4 THEN 1 ELSE 0 END AS application_fraud_flag,
CASE WHEN previous_claims >=3 THEN 1 ELSE 0 END AS claims_risk_flag,
CASE WHEN identity_verification_failed THEN 1 ELSE 0 END AS identity_fraud_flag
FROM fraud_applicants| applicant_id | application_fraud_flag | claims_risk_flag | identity_fraud_flag |
| A1001 | 0 | 0 | 0 |
| A1002 | 1 | 0 | 0 |
| A1003 | 0 | 1 | 1 |
| A1004 | 1 | 1 | 1 |
Calculating a Fraud Risk Score
A simple fraud scoring approach can combine multiple indicators.
SELECT
applicant_id,
(
    application_fraud_flag +
    claims_risk_flag +
    identity_fraud_flag
) AS fraud_score
FROM fraud_feature_store| applicant_id | fraud_score |
| A1001 | 0 |
| A1002 | 1 |
| A1003 | 2 |
| A1004 | 3 |
Underwriter Decision View
Fraud scores can be translated into easy-to-understand risk classifications.
SELECT
applicant_id,
fraud_score,
CASE
WHEN fraud_score >= 3 THEN 'High Risk'
WHEN fraud_score >= 2 THEN 'Medium Risk'
ELSE 'Low Risk'
END AS risk_category
FROM fraud_scores| applicant_id | fraud_score | risk_category |
| A1001 | 0 | Low Risk |
| A1002 | 1 | Low Risk |
| A1003 | 2 | Medium Risk |
| A1004 | 3 | High Risk |
Leveraging Delta Lake Features for Fraud Analytics
ACID Transactions
Fraud datasets often receive updates from multiple systems simultaneously. Delta Lake ensures:
- Consistent feature calculations
- Reliable updates
- No partial writes
Time Travel
Fraud investigations frequently require revisiting historical records. For instance,
SELECT * FROM fraud_feature_store VERSION AS OF 15Benefits:
- Investigation support
- Auditability
- Regulatory compliance
Schema Evolution
New fraud indicators emerge continuously. Examples:
- Device fingerprint score
- Geolocation risk score
- Synthetic identity probability
Delta Lake enables schema evolution without complex migrations.
spark.conf.set(
    "spark.databricks.delta.schema.autoMerge.enabled",
    "true"
)
Real-Time Fraud Detection
Combining Delta Lake with Delta Live Tables enables near real-time fraud scoring. Typical workflow:
- New application arrives.
- Identity verification completed.
- Claims history enriched.
- Fraud features generated.
- Fraud score calculated.
- Underwriter alerted.
Example streaming ingestion:
stream_df = (
    spark.readStream
    .format("cloudFiles")
    .option("cloudFiles.format","json")
    .load("/incoming-applications")
)
This allows insurers to identify suspicious applications before policy issuance.
Business Benefits
- Faster Underwriting Decisions: Underwriters receive consolidated fraud indicators instead of manually searching multiple systems.
- Improved Fraud Detection Accuracy: Multiple fraud signals provide stronger predictive power than isolated indicators.
- Reduced Operational Costs: Automated fraud feature generation minimizes manual investigation effort.
- Better Regulatory Compliance: Historic versions of fraud indicators can be reconstructed using Delta Lake Time Travel.
- Foundation for Machine Learning: The fraud feature store can directly support fraud classification models, risk scoring models, graph analytics, and entity resolution systems.
In-Summary
Underwriting fraud has become increasingly sophisticated, making it difficult for insurers to rely on isolated systems and manual reviews. Effective fraud detection requires combining application fraud signals, premium manipulation indicators, and identity verification results into a unified analytical framework.
Delta Lake provides the ideal foundation for this approach. By creating a centralized fraud feature store, insurers can consolidate disparate datasets, engineer reusable fraud indicators, maintain full auditability, and support both real-time analytics and machine learning initiatives.
The result is a faster, more accurate underwriting process that identifies potentially fraudulent applications before policies are issued, helping insurers reduce losses while improving decision quality and operational efficiency.